Dette er en kort historie om hvordan SMOC.AI byttet til Cloudflare for å bygge en personlig, automatisert salgsagent-bot med lav ventetid og høy skalerbarhet.
SMOC.AIs salgsagent-bot spiller en viktig rolle i våre kunders leadgenereringsstrategi. Hver måned gjennomfører den hundretusener av samtaler med besøkende på kundenes nettsider.
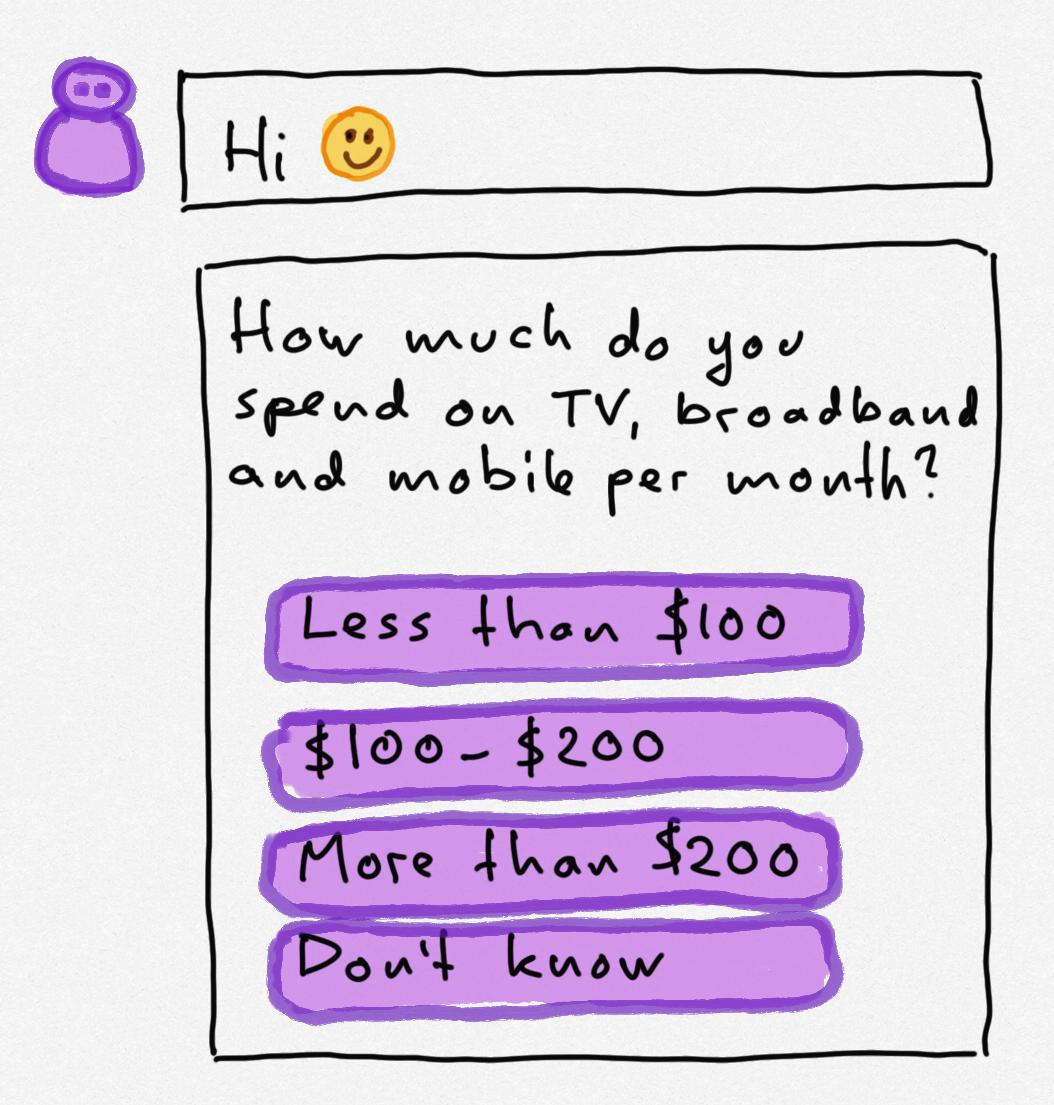
Boten stiller en rekke spørsmål til besøkende som en quiz. Besøkende velger mellom flere svaralternativer ved å trykke på knapper. Hvilket spørsmål boten stiller videre, avhenger av tidligere svar. På slutten av samtalen blir besøkende ofte bedt om å legge igjen kontaktinformasjon for et personlig oppfølgingstilbud.
Disse samtalene øker leadgenerering for våre kunder med 200-500 %.
Kundene våre elsker det, og fornøyde kunder alltid ber om mer. Noen av våre mest populære funksjonsønsker er:
- Kan dere tilpasse samtalen til hver besøkende for å øke leadgenerering enda mer?
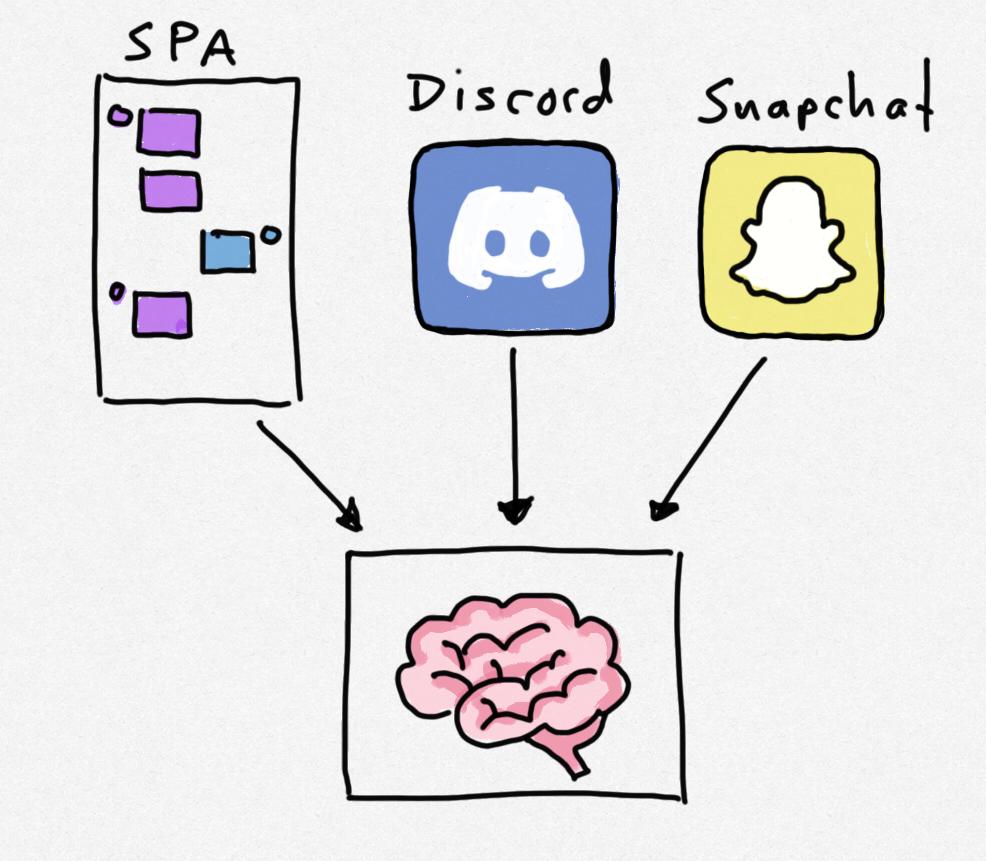
- Vi ønsker å nå ut til målgrupper utenfor nettet (Discord / SnapChat osv). Kan dere få det til å fungere der?
- Vi er i Asia – hvorfor tar det så lang tid å laste inn boten?
For 6 måneder siden kunne vi ikke tilfredsstille noen av disse funksjonsønskene på grunn av hvordan systemet vårt var bygget – som en tradisjonell 3-lags arkitektur med en Single Page Application (SPA) i JavaScript og et par dedikerte servere.
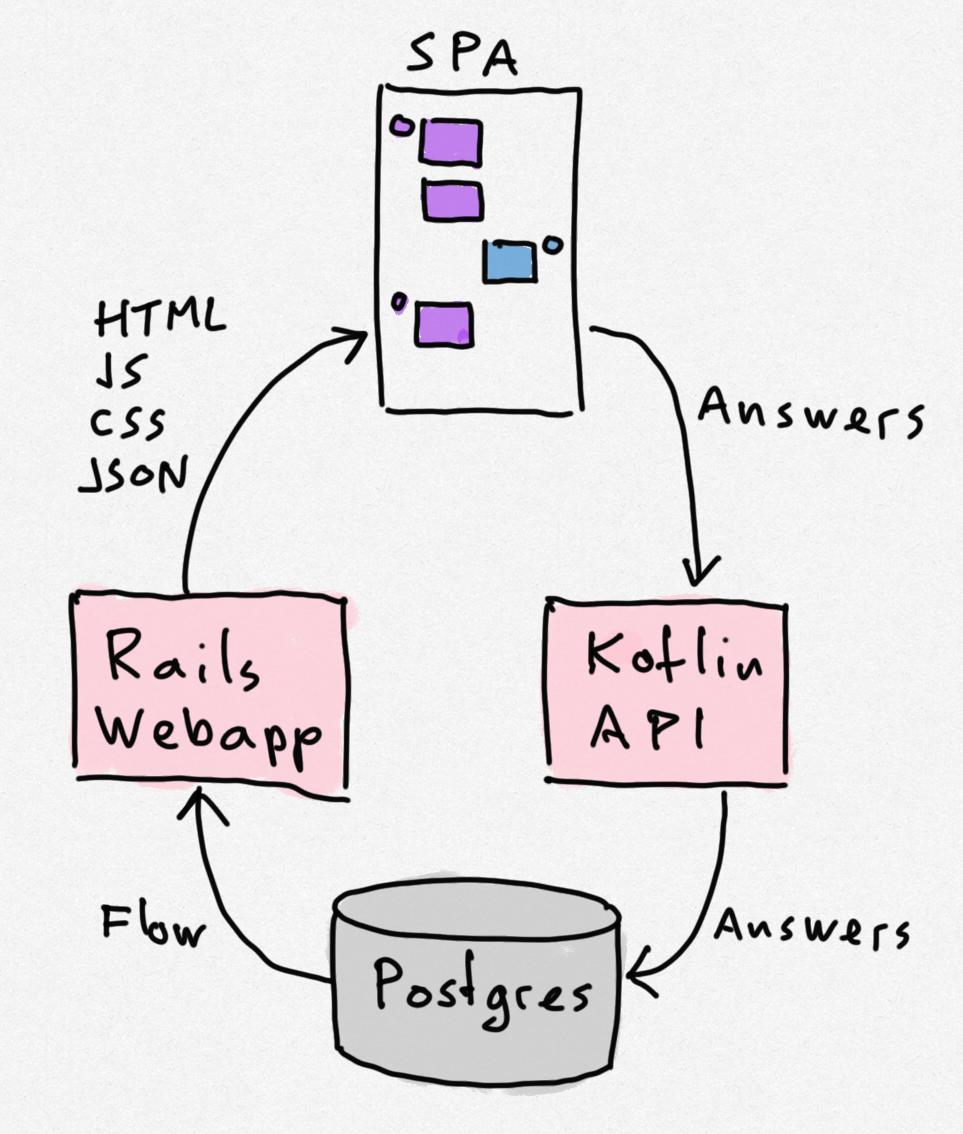
- Rails-nettappen leverte HTML, CSS, SPA-kode og et flyt-JSON til nettleseren
- SPA-en kommuniserte med en API-server over HTTP
- API-serveren mottok svarene og lagret dem i Postgres
- Postgres-databasen lagret alle svarene
SPA-en lastet inn en rettet graf over alle mulige bot-meldinger (en flyt) i minnet ved starten av en samtale. Hver gang en besøkende trykket på en knapp, fulgte SPA-en en kant i grafen til neste spørsmål og viste det på skjermen.
Alle avgjørelser om hva boten skulle si videre ble gjort i SPA-en som kjørte i nettleseren.
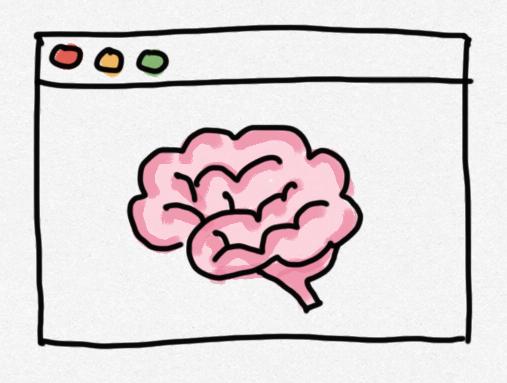
Botens (erter-)hjerne var bokstavelig talt i nettleseren.
For å gi en personlig opplevelse til hver besøkende, bestemte vi oss for å bygge en maskinlæringsmodell for å avgjøre hvilken kant som var best å følge videre. Vi måtte gjøre hjernen smartere og større. Dette ville være mye enklere å få til hvis vi flyttet samtalelogikken fra nettleseren til serveren.
Med all samtalelogikken på serveren ville det også være mulig å integrere samtalemotoren vår med andre plattformer som Discord og SnapChat.
Med samtalelogikken som kjører på en server, måtte vi dytte bot-meldinger til klientenhetene. På webben ville dette gjøres over en WebSocket.
Vi måtte håndtere minst 10 000 samtidige WebSockets til vanlig, og over 100 000 når kundene våre kjører store annonsekampanjer som gir topper.
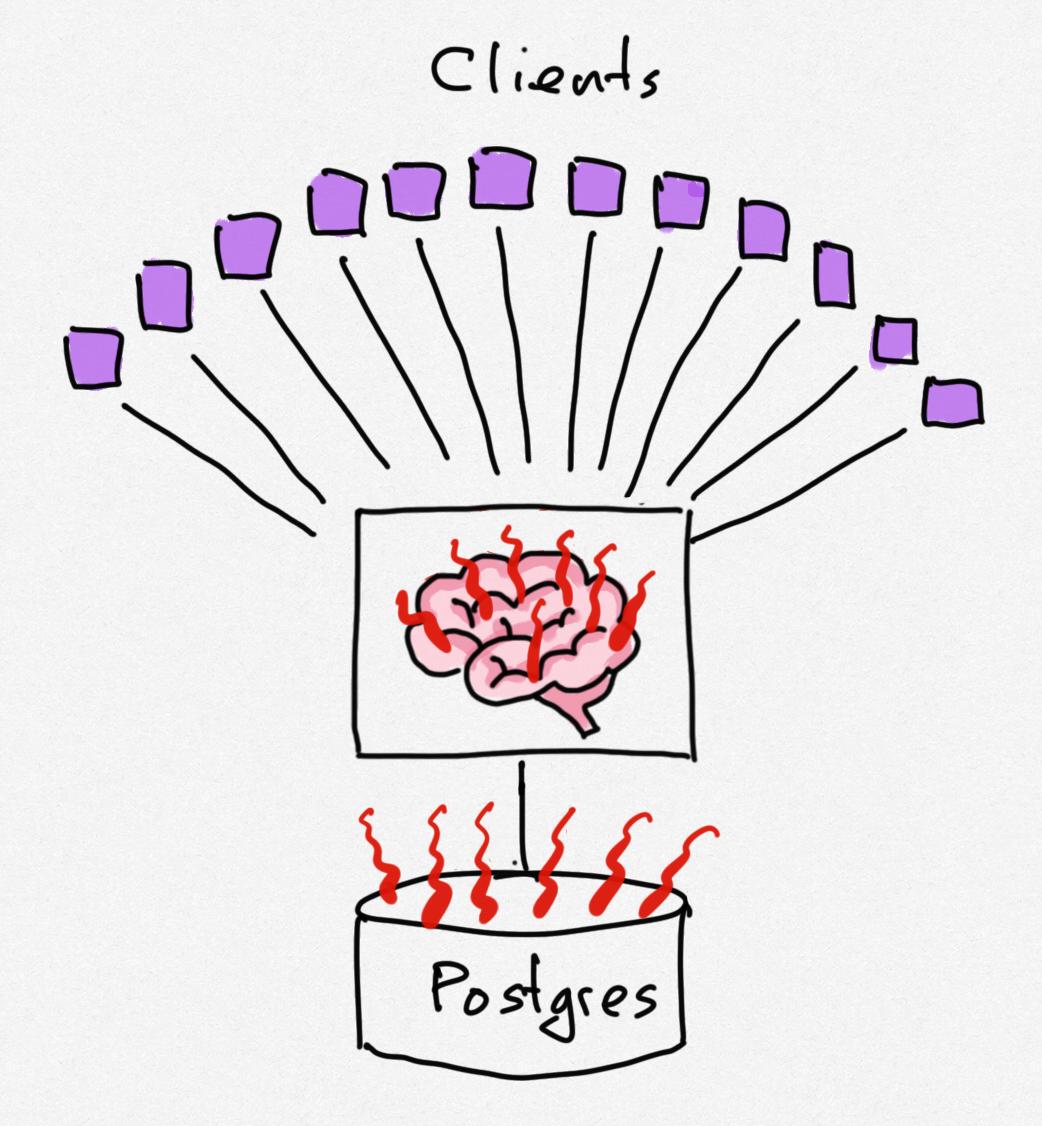
Denne typen samtidig I/O ville ikke fungere godt på de dedikerte EC2-serverne vi hadde. Det ville blitt én varm hjerne! Eller kanskje ti, men fortsatt varme. Vi trengte en arkitektur som kunne skalere raskere og til lavere kostnad.
Vi visste allerede at vår nåværende arkitektur kunne føre til skrivekø i Postgres-databasen, så vi ønsket også å unngå det.
Vår nye arkitektur måtte håndtere massive belastninger, og den måtte også være tilgjengelig over hele verden slik at besøkende ikke må vente mer enn 100 ms på at boten skal laste. Med andre ord måtte den leve på kanten.
Siden vi allerede brukte AWS, vurderte vi først å bruke lambdas. Lambdas er flotte, men de støtter ikke WebSocket-tilkoblinger med mindre du hopper gjennom ringer.
Vi bestemte oss for å se nærmere på CloudFlare Durable Objects, og innså raskt at dette ville være en perfekt match for våre behov. Hvis du ikke er kjent med Durable Objects, kan du tenke på dem som langvarige lambdas med tilstand og en dedikert WebSocket.
Det tok to ingeniører noen måneder å skrive om bot-motoren til denne arkitekturen. Som en del av dette arbeidet tok vi også i bruk Cloudflare KV for å lagre samtaledata i stedet for Postgres.
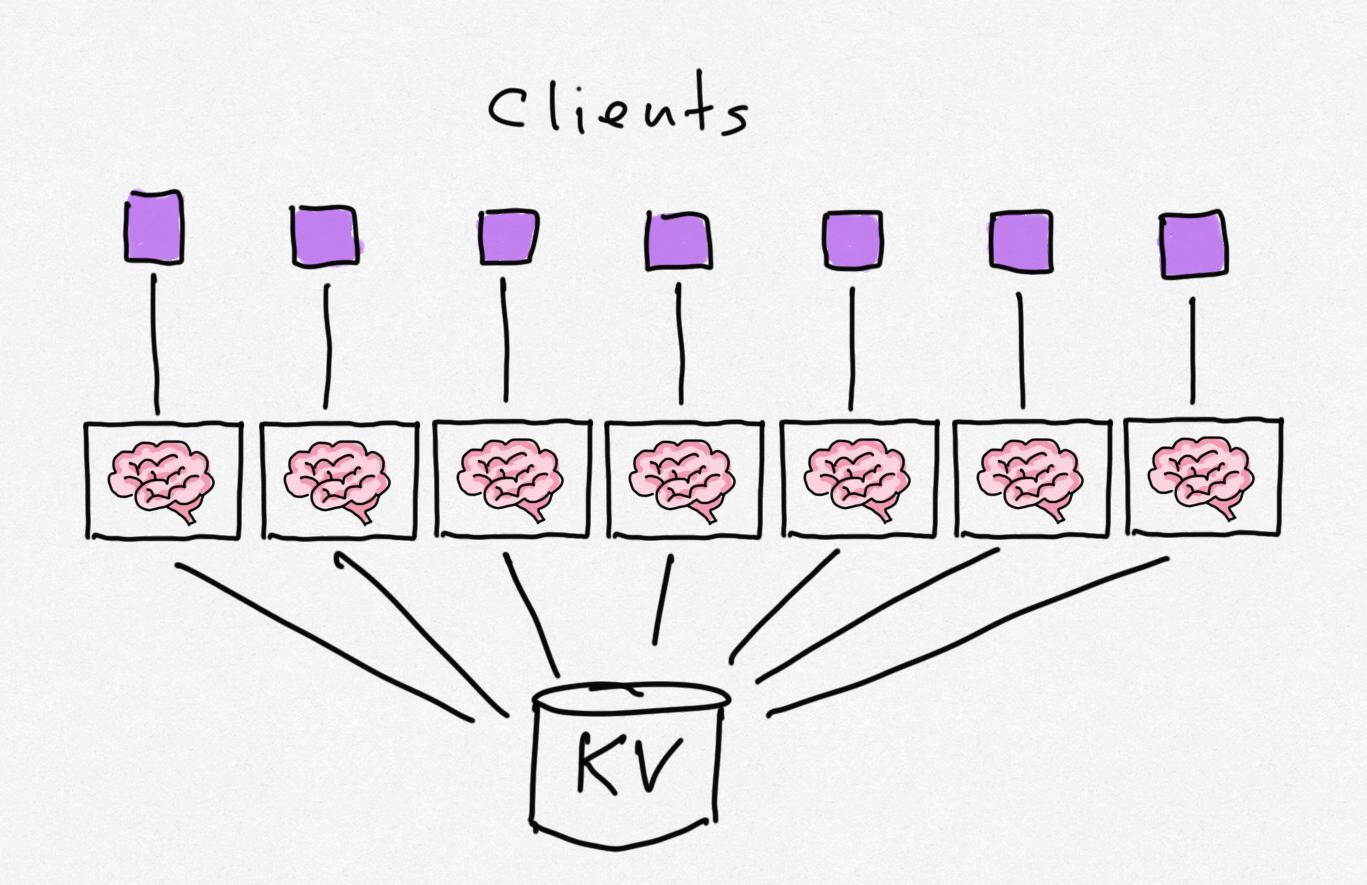
Hver gang en ny besøkende starter en samtale, oppretter Cloudflare umiddelbart et nytt Durable Object for å håndtere samtalen. Vi trenger ikke lenger å bekymre oss for skalering.
Så langt har Cloudflare-stacken vært flott å jobbe med. Den skalerer ikke bare ekstremt bra, den har også en utmerket utvikleropplevelse (DX) slik at vi kan bruke mer tid på å bygge programvare og mindre tid på å administrere infrastruktur.
Vi har et sett med hundrevis av automatiserte tester som kjører på omtrent 2 sekunder, så det å iterere og eksperimentere er ekstremt raskt.
Med denne arkitekturen på plass er vi godt posisjonert til å begynne å bygge vår nye maskinlæringsmodell som vi skal koble til alle disse små hjernene. Den vil bruke bayesiansk inferens for å velge kanter i flytdiagrammene våre. Jeg skal fortelle mer om det i et fremtidig blogginnlegg.
SMOC.AI ansetter. Vi ser etter fullstack-utviklere med ML-erfaring. Hvis du er interessert i å lære mer, send en e-post til [email protected].