Det här är en kort berättelse om hur SMOC.AI bytte till Cloudflare för att bygga en personlig, automatiserad säljagent-bot med låg latens och hög skalbarhet.
SMOC.AIs säljagent-bot spelar en viktig roll i våra kunders leadgenereringsstrategi. Varje månad genomför den hundratusentals samtal med besökare på kundernas webbplatser.
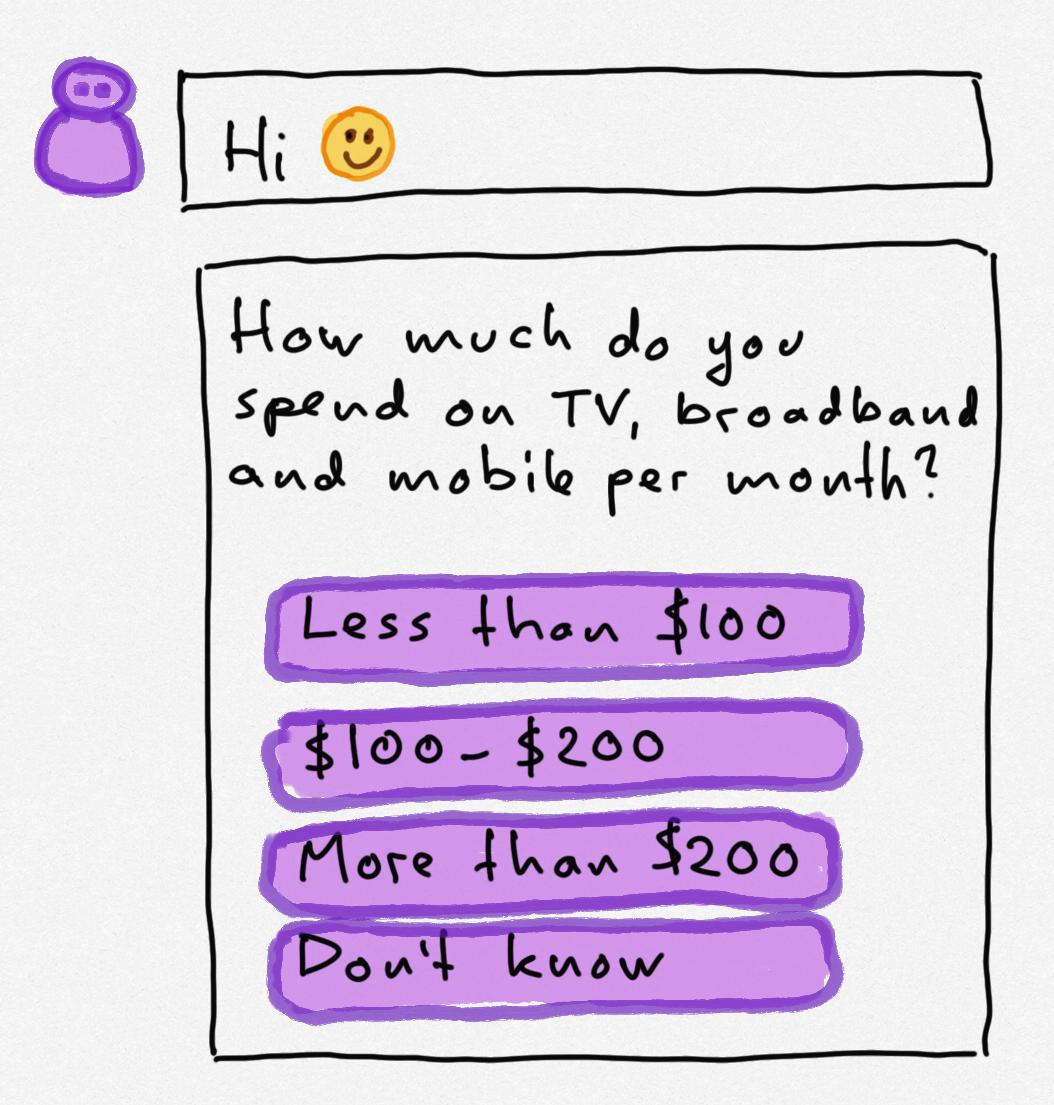
Botten ställer en serie frågor till besökaren som ett quiz. Besökaren väljer sedan mellan flera svarsalternativ genom att trycka på knappar. Nästa fråga som botten ställer beror på tidigare svar. I slutet av konversationen ombeds besökaren ofta att lämna sina kontaktuppgifter för ett personligt uppföljningserbjudande.
Dessa konversationer ökar leadgenerering för våra kunder med 200–500 %.
Våra kunder älskar det, och nöjda kunder alltid ber om mer. Några av våra mest populära funktionsönskemål är:
- Kan ni anpassa konversationen till varje besökare för att öka leadgenerering ännu mer?
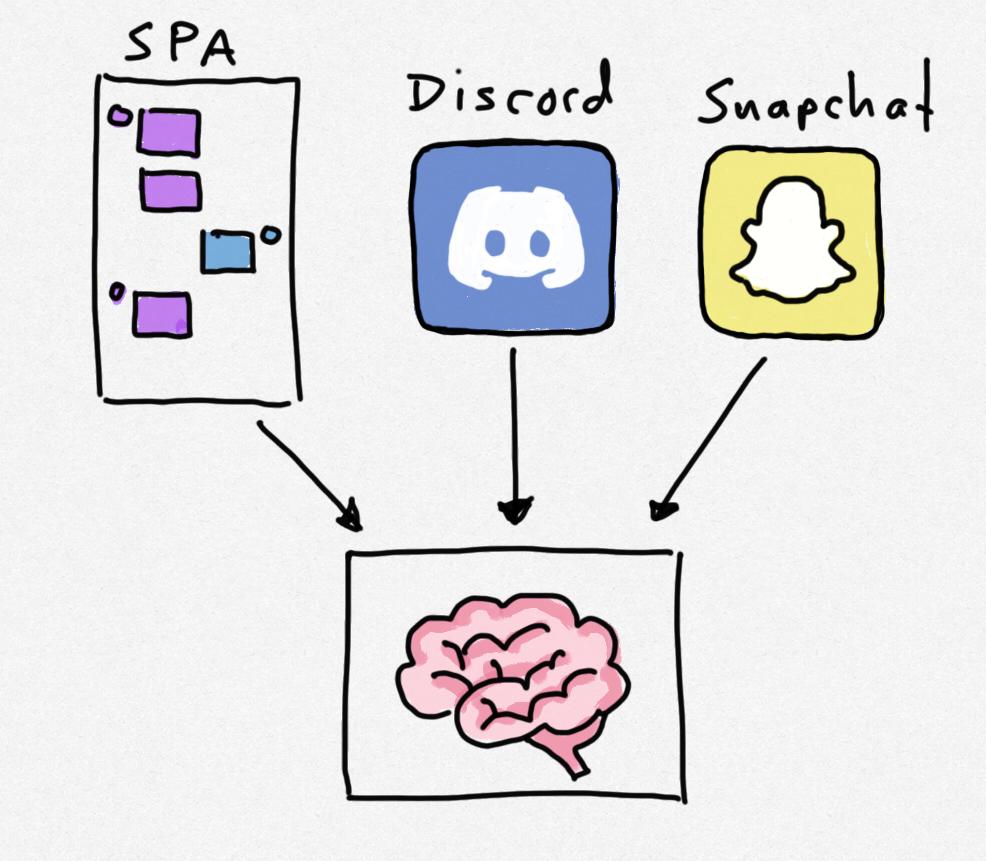
- Vi vill nå målgrupper utanför webben (Discord / SnapChat etc). Kan ni få det att fungera där?
- Vi är i Asien – varför tar det så lång tid att ladda botten?
För 6 månader sedan kunde vi inte tillgodose något av dessa funktionsönskemål på grund av hur vårt system var uppbyggt – som en traditionell 3-lagersarkitektur med en Single Page Application (SPA) i JavaScript och ett par dedikerade servrar.
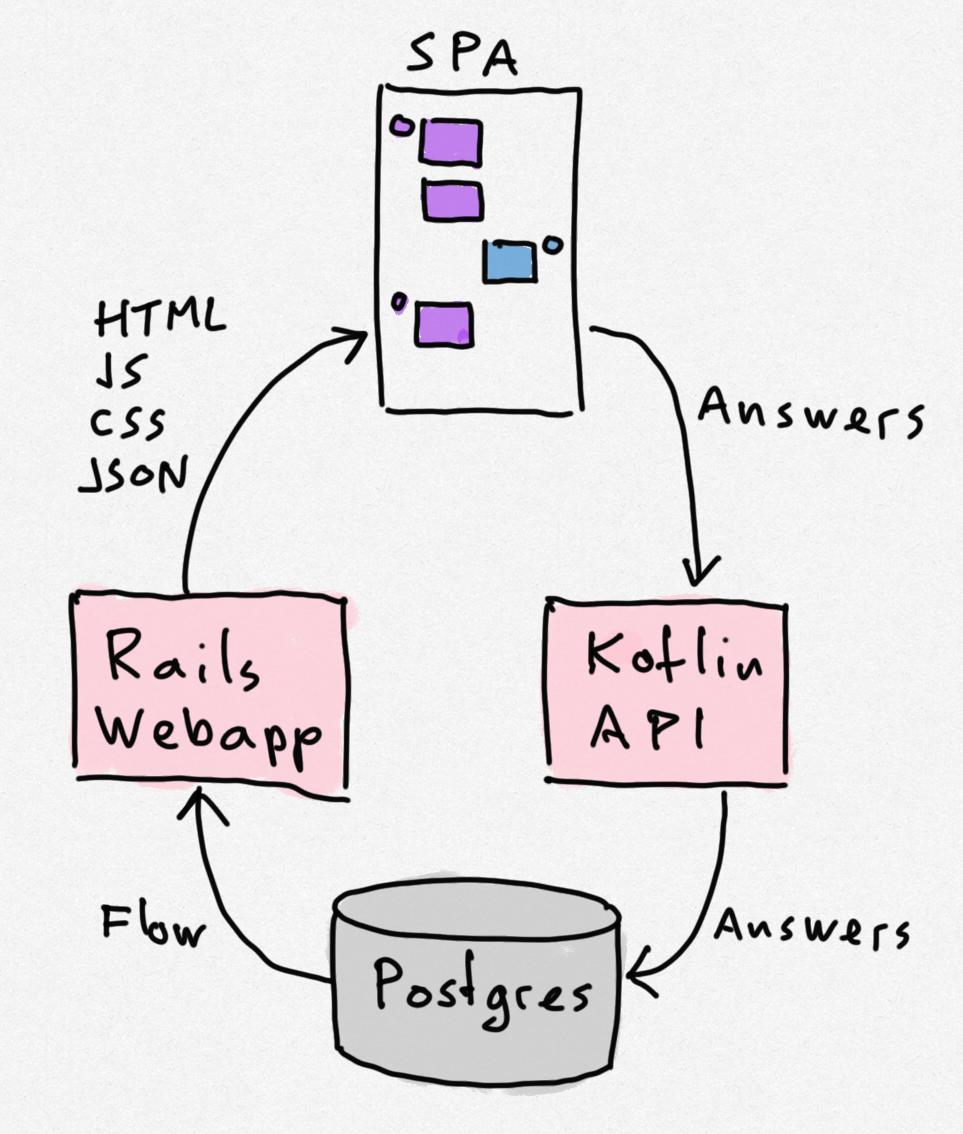
- Rails-webbappen levererade HTML, CSS, SPA-kod och ett flödes-JSON till webbläsaren
- SPA:t kommunicerade med en API-server via HTTP
- API-servern tog emot svaren och skrev dem till Postgres
- Postgres-databasen lagrade alla svaren
SPA:t laddade ett riktat diagram över alla möjliga bot-meddelanden (ett flöde) i minnet i början av en konversation. Varje gång en besökare tryckte på en knapp följde SPA:t en kant i diagrammet till nästa fråga och visade den på skärmen.
Alla beslut om vad boten skulle säga härnäst togs i SPA:t som kördes i webbläsaren.
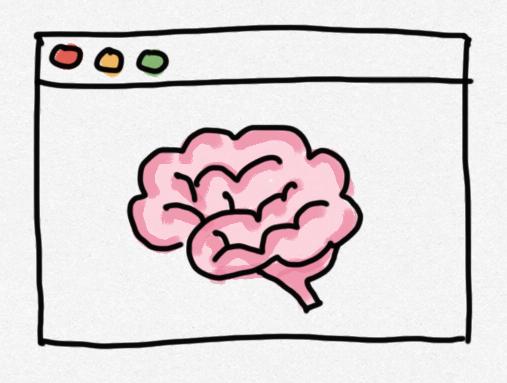
Botens (ärthjärna) satt bokstavligen i webbläsaren.
För att ge varje besökare en personlig upplevelse bestämde vi oss för att bygga en maskininlärningsmodell för att avgöra vilken kant som var bäst att följa härnäst. Vi behövde göra hjärnan smartare och större. Det skulle vara mycket enklare att genomföra om vi flyttade konversationslogiken från webbläsaren till servern.
Med all konversationslogik på servern skulle det också vara möjligt att integrera vår konversationsmotor med andra plattformar som Discord och SnapChat.
Med konversationslogiken som körs på en server skulle vi behöva skicka bot-meddelanden till klientenheterna. På webben skulle detta göras via en WebSocket.
Vi skulle behöva hantera minst 10 000 samtidiga WebSockets regelbundet, och över 100 000 när våra kunder kör stora annonskampanjer som orsakar toppar.
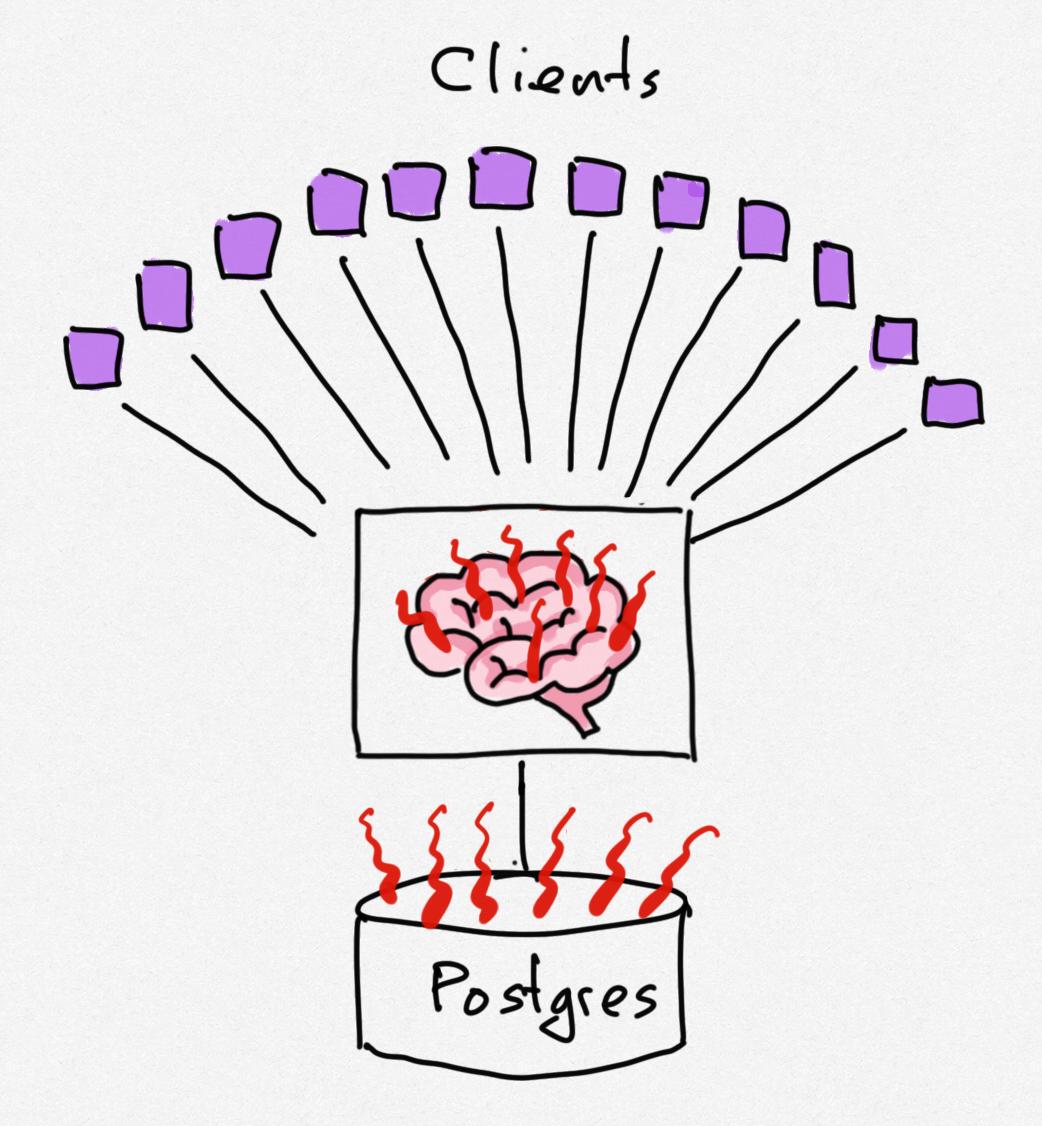
Den här typen av samtidiga I/O skulle inte fungera bra på de dedikerade EC2-servrar vi hade. Det skulle bli en het hjärna! Eller kanske tio, men ändå heta. Vi behövde en arkitektur som kunde skala snabbare och till en lägre kostnad.
Vi visste redan att vår nuvarande arkitektur kunde leda till skrivköer i Postgres-databasen, så vi ville också undvika det.
Vår nya arkitektur behövde klara av massiva belastningar, och den behövde också vara tillgänglig globalt så att besökare inte behöver vänta mer än 100 ms på att boten ska laddas. Med andra ord behövde den finnas vid kanten.
Eftersom vi redan använde AWS övervägde vi först att använda lambdas. Lambdas är bra, men de stöder inte WebSocket-anslutningar om du inte hoppar genom ringar.
Vi bestämde oss för att titta närmare på CloudFlare Durable Objects och insåg snabbt att detta skulle vara perfekt för våra behov. Om du inte är bekant med Durable Objects, kan du tänka på dem som långlivade lambdas med tillstånd och en dedikerad WebSocket.
Det tog två ingenjörer några månader att skriva om botmotorn för denna arkitektur. Som en del av detta arbete började vi också använda Cloudflare KV för att lagra konversationsdata istället för Postgres.
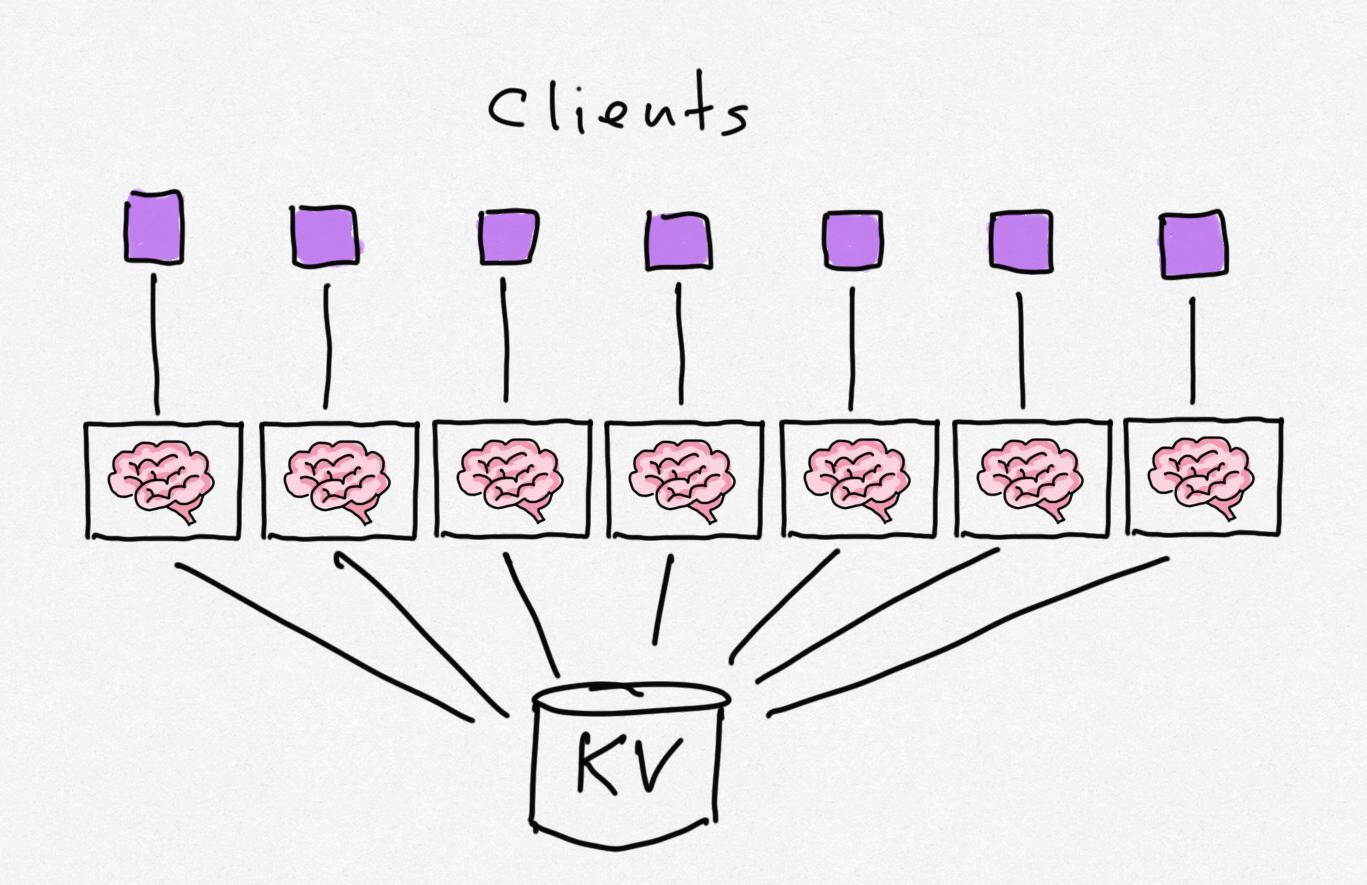
Varje gång en ny besökare startar en konversation skapar Cloudflare omedelbart ett nytt Durable Object för att hantera samtalet. Vi behöver inte längre oroa oss för skalning.
Hittills har Cloudflare-stacken varit fantastisk att arbeta med. Den skalar inte bara extremt bra, den har också en utmärkt utvecklarupplevelse (DX) så vi kan lägga mer tid på att bygga mjukvara och mindre tid på att hantera infrastruktur.
Vi har en uppsättning med hundratals automatiserade tester som körs på cirka 2 sekunder, så att iterera och experimentera är extremt snabbt.
Med denna arkitektur på plats är vi väl positionerade för att börja bygga vår nya maskininlärningsmodell som vi kommer att koppla till alla dessa små hjärnor. Den kommer att använda bayesiansk inferens för att välja kanter i våra flödesgrafer. Jag berättar mer om det i ett framtida blogginlägg.
SMOC.AI rekryterar. Vi söker fullstackutvecklare med ML-erfarenhet. Om du är intresserad av att veta mer, skicka ett mejl till [email protected].